你用中文問 ChatGPT,台灣哪幾家廠商值得合作,看到自家品牌在名單上,鬆了一口氣。
但你的國外買家,不是用中文問的。
2026 年 10 月 13 日,Search Engine Journal(SEJ)刊出一份單一作者實測:同一個 AI、同一道購物問題,只把提問的語言換掉,推薦的品牌就變了。作者是 SALT.agency 共同創辦人 Reza Moaiandin,測的是他自己設計的題目。
多語系 SEO 過去處理的是:搜尋引擎找不找得到對的語言版本。現在多了一層:AI 用不同語言回答時,還會不會推薦你。
這篇整理三份一手資料:SEJ 的實測數據、Anthropic 對 Claude 跨語言表現的研究,以及一篇觀察 ChatGPT 怎麼改寫中文問題的論文。最後給外銷企業一套分語言自查、分語言記錄的做法。
 圖說:同一個問題換五種語言問,AI 給出的首選品牌可能各不相同。
💡 不確定 AI 現在怎麼介紹你?先做一次免費 AI 可見度快篩。
重點摘要: SEJ 刊出的單一作者測試(Reza Moaiandin,2026-10-13)用 Claude Sonnet 5、關閉網路搜尋,以五種語言各問 40 次。機票情境用波斯文問,52.5% 推薦英國航空;用俄文問,72.5% 推薦 easyJet,一次都沒推薦英國航空。用中文查得到你,不保證外國買家用他們的語言問時也看得到你。
多語系 SEO 多了一個新問題:AI 搜尋換不同語言,答案就不同
會變,至少在一份單一作者測試裡是這樣:同一個模型、同一個情境、同一天下午,只換提問語言,首選品牌就不同。作者 Reza Moaiandin 的原話是「Same model, same scenario, same question, same afternoon. The only difference was the language.」(Search Engine Journal, 2026)。
為什麼不能只看中文結果?
作者在文中解釋,用另一種語言問 AI 時,回答「won’t simply be a translation of the answer it would give in English」。AI 是直接用那個語言推理、組織答案,不是先想好英文答案再翻譯。
這對多語系 SEO 是一個新課題。過去做多國語系 SEO,重點是讓搜尋引擎找到對的語言版本、排給對的國家。現在還要多問一句:買家用他的語言問 AI 時,AI 推薦的是誰?
而這些買家用的 AI,多半跟你一樣。SEJ 文中引 Statcounter 2026 年 8 月數據:在沙烏地阿拉伯、哈薩克、新加坡,來自 AI 聊天機器人的網站造訪約四分之三來自 ChatGPT;加上 Claude、Gemini,三者在各市場合計超過 90%。
同一批 AI,換一種語言,答案卻可能不同。這就是這篇要處理的問題。
AI 推薦品牌會因語言改變嗎?一份 1,650 則回答的單一作者實測
會,但不是每個產業都會。SEJ 這份單一作者測試共蒐集 1,650 則回答;六個購物情境裡,機票與飯店兩類的首選品牌隨語言大幅變動,耳機、掃地機器人、CRM、專案管理軟體四類,五種語言的首選品牌都一樣(Search Engine Journal, 2026)。
測試怎麼做
先看測試設計,才知道這些數字能用到哪裡:
| 項目 | 內容 |
|---|---|
| 作者 | Reza Moaiandin(SALT.agency 共同創辦人) |
| 發表 | 2026 年 10 月 13 日,Search Engine Journal |
| 蒐集時間 | 2026 年 9 月 7 日,同一個下午 |
| 主測模型 | Claude Sonnet 5,關閉網路搜尋,透過 DataForSEO 的 LLM Responses API 發問 |
| 語言 | 英文、阿拉伯文、俄文、簡體中文、波斯文(沒有測繁體中文) |
| 情境 | 特內里費(Tenerife)飯店、倫敦往返特內里費機票、400 英鎊以下降噪耳機、500 英鎊以下掃地機器人、英國小型企業 CRM、50 人英國公司的專案管理軟體 |
| 問法 | 每次要求列出三個品牌選項,並說出推薦哪一個 |
| 樣本 | 核心資料 6 情境 × 5 語言 × 40 次=1,200 則;加上開網路搜尋與跨模型比較,總共 1,650 則 |
要特別注意一點:這份測試量的是首選推薦,也就是 AI 最後說推薦哪一個品牌,不是 AI 有沒有引用你的網頁。兩者差在哪,可以看被 AI 推薦和被 AI 引用的差別。
落差最大的兩類:機票與飯店
機票情境的落差最大。下表是各語言 40 則回答中,三家航空公司被選為首選的比例:
| 航空公司 | 英文 | 阿拉伯文 | 俄文 | 簡體中文 | 波斯文 |
|---|---|---|---|---|---|
| 英國航空(British Airways) | 12.5% | 45.0% | 0(一次都沒有) | 10.0% | 52.5% |
| Jet2 | 45.0% | 22.5% | 25.0% | 32.5% | 32.5% |
| easyJet | 35.0% | 17.5% | 72.5% | 50.0% | 12.5% |
用波斯文問,52.5% 推薦英國航空,easyJet 只有 12.5%。用俄文問,72.5% 推薦 easyJet,英國航空一次都沒出現。作者把 easyJet 在兩種語言間的落差稱為「a staggering 60-point swing」。
飯店情境也一樣明顯。Bahía del Duque 在簡體中文回答裡有 43.6% 是首選,阿拉伯文只有 7.7%。Hotel Botánico 在英文約占三分之一(32.5%),到了俄文完全沒出現。
飯店的百分比普遍比較低,原因是特內里費的飯店選擇多,推薦本來就比較分散。另外,作者排除了 3 則沒說出首選的回答,所以有兩組百分比的分母是 39 則,不是 40 則。
也有四類很穩定
不是每一類都會變。另外四個情境,五種語言的首選品牌都相同:
| 情境 | 五種語言都選的首選 | 比例範圍 |
|---|---|---|
| 降噪耳機 | Sony | 英文 50.0%(Bose 42.5% 緊追),其他四語 87.5%~100% |
| 掃地機器人 | Roborock | 87.5%~97.5% |
| CRM | Zoho CRM | 75.0%~95.0% |
| 專案管理軟體 | Monday.com | 45.0%~55.0% |
為什麼有的類別穩、有的類別晃?作者也沒有答案,原文寫「For now, I can only guess at why some categories are stable across all languages while others see such huge variations.」
打開網路搜尋之後
多數人用 AI 時會開著網路搜尋。所以作者又挑了飯店、專案管理軟體兩個情境,開搜尋再測五種語言。
結果是:10 組語言與情境的組合裡,有 7 組的首選品牌跟關搜尋時不同。飯店情境更極端,五種語言的首選全部換掉。
最戲劇性的是一間改過名的飯店。2024 年 7 月,Iberostar Grand 系列改名為 JOIA by Iberostar。關搜尋時,模型還在用舊名,198 則回答裡只推薦過 2 次;開搜尋後,JOIA by Iberostar 拿下飯店整體 31%、英文 60% 的首選。專案管理軟體也有變化:阿拉伯文開搜尋後有 46.7% 選 Wrike,關搜尋時只有 5%。
但這段數據有一個重要的但書。開搜尋後,42.7% 的回答在寫完前就碰到輸出上限被截斷,波斯文高達 83%、阿拉伯文 63%。作者說模型通常先講首選、再講理由,所以大多數回答仍抓得到推薦品牌,但他也寫「I can’t rule out the possibility of these numbers being soft」。
作者對這組結果的解讀是:開搜尋後推薦會變,代表這些語言差異「are fluid and can be influenced」。這是作者的推論,不是證明。
換成 ChatGPT、Gemini 也一樣嗎
作者用同兩個情境、同樣關搜尋,測了 ChatGPT(gpt-5.6-sol)和 Gemini(gemini-3.5-flash)。10 組組合裡,Gemini 有 5 組的首選跟 Claude 相同,ChatGPT 只有 1 組。
ChatGPT 自己也有語言差異。專案管理軟體在 Claude 裡五語都選 Monday.com,到了 ChatGPT,Monday.com 一個語言都沒拿下,Wrike 拿下了四個語言。
作者的結論是,語言差異「not exclusive to any one AI model」,但這些發現應該當成「suggestive rather than definitive」。
這份測試的限制
作者自己列得很清楚,我們照原文整理:
- 樣本小:單一個下午蒐集,只測了少數模型、類別與語言
- 單次提及不算數:原文寫「Does one mention in 40 constitute evidence? No.」
- 不保證持續:沒有重測,「there’s no reason to assume these numbers and patterns will hold true from one week to the next」
- 沒有繁體中文:測的是簡體中文,不能直接推到台灣的繁體中文使用者
所以這份測試能告訴你的是:語言會影響 AI 推薦,值得你自己查。它不能告訴你,你的產業、你的品牌會怎麼變。
為什麼會這樣?Anthropic 研究:Claude 在不同語言的表達傾向不同
原因目前沒有定論。可以當背景參考的,是 Anthropic 在 2026 年 7 月 13 日發表的研究:抽樣 309,815 則 Claude.ai 對話,發現 Claude 表達的價值傾向會隨語言改變(Anthropic, 2026)。但這份研究量的是價值傾向,不是品牌推薦。
研究怎麼做、發現什麼
研究抽的是使用者交給 Claude 主觀性任務的對話,也就是沒有標準答案的問題,例如要不要換工作。樣本平均取自三個模型(Sonnet 4.6、Opus 4.6、Opus 4.7)與 Claude.ai 上最常用的 20 種語言,每個模型與語言的組合約 5,000 則,資料來自 2026 年 5 月的兩週。
研究把數千種價值壓縮成四條軸。控制任務、主題與使用者自己表達的價值之後,這四條軸合計解釋 15% 的價值變異:
| 價值軸 | 兩端在比什麼 | 跨語言變化 |
|---|---|---|
| Deference vs. Caution | 順著使用者想要的,還是提醒風險 | 最穩定的兩軸之一 |
| Warmth vs. Rigor | 正面鼓勵,還是強調準確 | 變化最大 |
| Depth vs. Brevity | 深入解釋,還是只做被要求的事 | 最穩定的兩軸之一 |
| Candor vs. Execution | 先講自己的不確定,還是給出有自信的成品 | 變化較大的兩軸之一 |
研究的結論原文是「The values Claude expresses vary across languages.」差異最大在 Warmth vs. Rigor:阿拉伯文、印地文最偏溫暖,英文、俄文最偏嚴謹。
研究自己舉了一個例子:兩個人分別用印地文和俄文,請 Claude 評同一份商業計畫,可能「may come away with different impressions of its quality」。
這份研究不能拿來推論什麼
這裡要劃清界線。
Anthropic 這份研究量的是價值傾向,不是 Claude 推薦哪個品牌。SEJ 作者自己也寫明:「One thing the Anthropic research doesn’t test is whether the choice of language also impacts whether Claude mentions, cites or recommends your brand in the first place.」
所以,它不能解釋 SEJ 的機票、飯店結果,也不能讀成 Claude 偏好某個品牌。它能說明的只有一件事:模型用不同語言回答時,本來就不是單純翻譯。
連 Anthropic 自己都還在找原因。研究寫「We don't yet know which properties of our training data drive these differences.」,可能之一是訓練資料在各語言分布不均;這些差異合不合理,研究也寫「We also aren’t yet sure how much of this variation is desirable.」
對台灣外銷企業的影響:中文查得到你,不等於英文買家看得到你
只用中文查 AI 的結果做決策,等於只看一個市場的地圖。有一篇 2026 年 10 月 11 日發表的論文(arXiv 2610.15382)觀察到,中文問題送進 ChatGPT 後,chatgpt-5.3-instant 與 chatgpt-5.5-instant 分別有 67.0%、69.6% 的回答只用英文查詢(arXiv, 2026)。
外銷 SEO 的老問題是:英文網站 SEO 做了沒?新問題是:AI 用英文、日文、阿拉伯文回答時,有沒有你?
ChatGPT 會把中文問題改寫成英文查詢
這篇論文由西安交通大學、新加坡國立大學等團隊發表,觀察 ChatGPT 在網路搜尋時怎麼改寫問題、怎麼挑引用。它的樣本設計是:
- 80 個問句取自 Search Arena 資料集,四種意圖各 20 句,每種意圖中文、英文各 10 句
- 資料期間 2026 年 3 月 29 日到 7 月 29 日
- chatgpt-5.3-instant 與 chatgpt-5.5-instant 各跑 80 題 × 20 次,共 1,600 次
跟語言有關的發現:
| 觀察項目 | chatgpt-5.2-instant | chatgpt-5.3-instant | chatgpt-5.5-instant |
|---|---|---|---|
| 中文問題的查詢語言 | 96.8% 同時發出中文與英文查詢 | 67.0% 只用英文查詢 | 69.6% 只用英文查詢 |
| 原句照搜的比例 | 5.5% | 0% | 0% |
表格有兩個細節要知道。第一,chatgpt-5.3-instant 的實際查詢只在 1,600 次裡的 1,339 次觀察得到。第二,chatgpt-5.2-instant 只涵蓋 32 題,因為它在資料蒐集完成前就下架了(arXiv 2610.15382, 2026)。
AI 會把你的問題改寫、拆成好幾個查詢再去搜,原理可以看查詢擴展(Query Fan-Out)解析。
把 SEJ 和這篇論文放在一起看,我們的推論是:外銷企業的英文內容,可能同時影響英文買家,以及一部分用中文提問的人看到的答案。這只是推論,兩份素材都沒有直接證明這點;論文的中文問句取自 Search Arena 資料集,也不是專門針對台灣繁體中文的情境,不能直接套到台灣買家身上。
 圖說:同一個品牌,換一種語言問,AI 不一定會推薦你:有的語言市場亮燈,有的語言市場暗著。
外銷策略要多一張地圖
外銷行銷一向是按市場分:哪個國家、哪個通路、哪種語言的型錄。AI 能見度也該照這個邏輯分。
你在中文問題裡排第一,不代表在其他語言的問題裡也排第一。SEJ 單一作者測試的耳機例子剛好相反:Sony 在其他四種語言都是 87.5% 以上的首選,偏偏在英文只有 50.0%,Bose 以 42.5% 緊追。英文市場,不一定是你最穩的市場。
台灣企業整體的 GEO 規劃怎麼排優先順序,可以參考台灣企業 GEO 策略。
國際 SEO 怎麼做?AI 時代的多語系自查四步驟
國際 SEO 怎麼做,在 AI 時代多了一步:每個目標語言,各自查 AI 怎麼回答。SEJ 單一作者測試的作者 Reza Moaiandin(SALT.agency)建議「Take a handful of questions customers typically ask before they buy from your category.」,再到每個目標市場的語言、多個 AI 模型裡重複測試(Search Engine Journal, 2026)。
照這個建議,我們整理成四個步驟:
| 步驟 | 要做什麼 | 注意事項 |
|---|---|---|
| 1 | 列出目標市場與語言 | 以買家實際用的語言為準,不是公司想做的語言 |
| 2 | 每個語言各準備一組購買前會問的問題 | 用當地買家的說法,不要把中文題目直譯 |
| 3 | 每題跨多個 AI 平台、各問多次、固定週期重跑 | 每次記下實際回答的模型 |
| 4 | 把各語言版本的網站基本功做好 | 網址結構、hreflang、在地化內容、品牌資訊一致 |
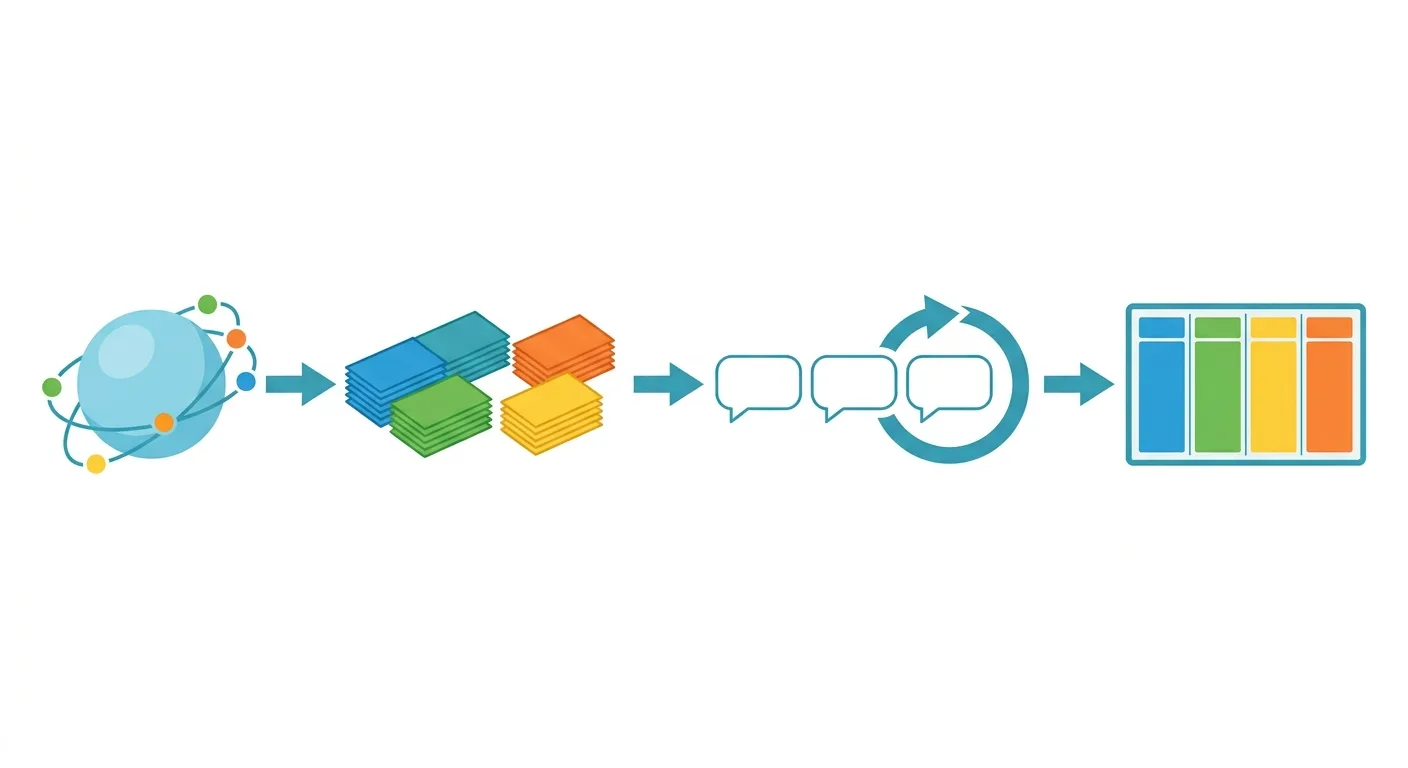 圖說:多語系自查四步驟:選定語言、每種語言各一組問題、多平台多次重跑、分語言記錄。
步驟 1:列出買家實際用的語言
先問:你的買家用什麼語言問 AI?
答案不一定是你網站有的語言。賣到中東的,買家可能用阿拉伯文;賣到東南亞的,可能是英文,也可能是當地語言。SEJ 那篇單一作者測試的文中提到,洛杉磯郡有超過一半的居民在家說英文以外的語言,就是提醒你:同一個國家,也可能有好幾種買家語言。
步驟 2:每個語言一組購買前問題
照 SEJ 作者的建議,挑幾個客戶在購買前常問的問題。
關鍵是用當地買家的說法。中文說推薦、英文說 best,日文又有自己習慣的問法,直譯出來的題目,可能沒有真正的買家會這樣問。題目數量不用多,先求每個語言都有、而且每次問法固定。
步驟 3:多平台、多次、固定週期重跑
同一題只問一次,結果參考價值很低。SEJ 單一作者測試每組問 40 次,作者還是說 40 次裡的 1 次不算證據;arXiv 那篇論文每題跑 20 次。
還有一個容易忽略的坑:重複量測時,服務的模型可能被悄悄換掉。論文提到,有兩個工作階段在成功跑了 14 次和 16 次之後,被切換到備援模型,所以建議每一則回答都確認實際服務的模型。
每個 AI 平台怎麼查、提示詞怎麼下,可以照 AI 引用自查教學 的清單一個一個試。
步驟 4:把各語言版本的網站基本功做好
hreflang、語言版本的網址結構、在地化內容,是多語系 SEO 的基本功,用途是讓搜尋引擎辨識你有哪些語言版本、各給哪個市場。它們會不會直接影響 AI 推薦,目前三份資料都沒有數據;但 AI 開網路搜尋時要找得到對的語言版本,基本功還是得先做好。做法可以參考製造業 SEO 指南裡國際市場那一段。
SEJ 作者的推論是,開搜尋後推薦會變,代表語言差異可以被影響。能下手的地方,就是 AI 搜得到的線上內容。我們的做法也是把內容寫在客戶自己的官網上,讓 AI 搜尋時讀得到品牌第一手的說法。
最後,每個語言版本的品牌資訊要一致:公司名、產品名、規格、聯絡方式。各語言版本說法不同,AI 就可能拼湊出錯的版本,處理方式見建立品牌單一真相來源。
客戶在國外?先看看他們問 AI 時有沒有你
買家用英文或當地語言問 AI 時,推薦名單上有沒有你?AI SEO Hacker 可以跟你聊聊外銷客群的 AI 能見度健檢,從你的目標市場開始排優先順序。
分語言記錄 AI 能見度:別只看總數
追蹤 AI 能見度時,記錄表要多一欄語言,同一題、同一平台的英文、日文、中文結果分開記。理由很簡單:平均數會藏住某個語言的掛零。以 SEJ 單一作者測試(Reza Moaiandin,SALT.agency)的機票情境為例,英國航空整體首選率 24.0%,看起來不差,但俄文是 0(Search Engine Journal, 2026)。
同一張表再看 easyJet:整體 37.5%,拆開是俄文 72.5%、波斯文 12.5%。如果只看 37.5% 這個總數,你會以為各市場表現平均;實際上,你在某個語言市場是首選,在另一個市場幾乎不存在。總數適合看趨勢,決策要看各語言的數字。
記錄表可以這樣設計
| 欄位 | 為什麼要記 |
|---|---|
| 日期 | 結果會隨時間變,要能比較前後 |
| AI 平台 | 不同 AI 的推薦可能完全不同 |
| 實際回答的模型 | 服務的模型可能被切換到備援模型 |
| 提問語言 | 同一題換語言,首選可能就換了 |
| 題目 | 每次問法要固定,才能比較 |
| 首選品牌 | 這是 SEJ 那份測試量的東西 |
| 有沒有提到你、引用了哪些網址 | 推薦和引用是兩件事,分開記 |
我們替簽約客戶追蹤 AI 引用時,會用 AI 引用追蹤工具做固定題目、固定週期的測試。如果你的買家分布在多個語言市場,建議在同樣的固定題目上,再多加一欄語言。想用開源工具自己架一套追蹤,可以先看能自架的開源 AI 能見度追蹤工具。
品牌名稱要中英都抓
我們讀 SEJ 原文的量測方法段時,注意到一個很容易漏掉的細節:多數品牌名即使在非英文回答裡,也照樣用拉丁字母寫;但在機票情境,約 5% 的中文回答把英國航空寫成「英国航空」、easyJet 寫成「易捷航空」,旁邊沒有英文名。作者因此把中文、阿拉伯文的寫法加進比對清單。
套到你的品牌也一樣。如果你有中文名、英文名、簡稱,甚至當地市場習慣的譯名,全部都要列進比對清單,不然 AI 明明提到你,你的記錄表卻是 0。
次數要夠、層級要對
arXiv 那篇論文把同一題重跑 20 次,發現 chatgpt-5.3-instant 有 40.8%、chatgpt-5.5-instant 有 44.5% 的候選網址只在其中一次出現。換句話說,單次看到或沒看到,都不能下結論。
論文也比較了外部量測能找回多少實際引用。用 Google 搜尋加 OpenAI Responses API 當替代量測,合起來只找回實際引用網址的 28.3%(5.3-instant)與 26.2%(5.5-instant);放寬到網站層級,則是 50.3% 與 48.7%。所以除了單一網址,也要看整個網站有沒有被引用。完整的衡量框架,見 GEO 成效怎麼衡量。
模型換了,就重新比較
論文最後的建議是,GEO 策略「should be re-evaluated when the deployed setting or serving environment changes」。
AI 平台會更新模型,論文裡的 chatgpt-5.2-instant 就在資料蒐集完成前下架。每次換模型,就把那一次的結果當成新的基準,不要拿新模型的數字直接跟舊模型比。
常見問題 FAQ
多語系 SEO 和國際 SEO 差在哪?
多語系 SEO 偏重語言版本,讓搜尋引擎辨識同一頁的中文、英文、日文版本;國際 SEO 偏重目標國家市場,例如同是英文,要分美國和英國。兩者常一起做。AI 時代都要多看一層:SEJ 單一作者測試裡,同一題換語言問,機票情境的首選品牌就不同。
用繁體中文問 AI,結果會跟簡體中文一樣嗎?
目前沒有數據可以回答。SEJ 單一作者測試用的是簡體中文,沒有測繁體;arXiv 2610.15382 的中文問句取自 Search Arena 資料集,也不是針對台灣繁體中文的情境。要知道你的品牌在繁體中文問題裡的表現,只能自己用固定題目、多次重跑去查。
AI 開了網路搜尋,語言差異就會消失嗎?
不會。SEJ 單一作者測試開搜尋後,10 組語言與情境組合裡有 7 組的首選品牌改變,差異只是換了樣子。但開搜尋時有 42.7% 的回答被截斷,波斯文 83%、阿拉伯文 63%,數字可能偏軟。作者的解讀是,這代表語言差異可以被影響。
分語言查 AI 推薦,要測幾次才算數?
沒有標準次數。SEJ 單一作者測試每組問 40 次,作者仍說 40 次裡的 1 次提及不算證據;arXiv 論文每題跑 20 次,發現四成以上的候選網址只出現一次。建議固定題目、固定週期多次重跑,看趨勢而不是看單次結果。
ChatGPT 推薦品牌也會因語言不同嗎?
在 SEJ 的小樣本裡會。作者用 gpt-5.6-sol 測飯店與專案管理軟體兩個情境,也出現語言差異,而且 10 組組合裡只有 1 組首選跟 Claude 相同;Gemini(gemini-3.5-flash)有 5 組相同。樣本很小,作者自己說應該當成提示,不是定論。
外銷做多語系 SEO,AI 能見度也要分語言看
做外銷的企業,多語系 SEO 現在要多補一課:AI 用不同語言回答時,推薦名單可能不一樣。這篇整理的三份資料,可以歸納成三個重點:
- 語言會改變 AI 推薦:SEJ 單一作者測試裡,機票情境用波斯文問 52.5% 推薦英國航空,用俄文問則一次都沒推薦。但這是單一作者、單一下午的測試,你的產業不一定會這樣
- 原因還沒有定論:SEJ 作者只能猜,Anthropic 的研究發現 Claude 的價值傾向會隨語言改變,但它量的不是品牌推薦
- 能做的事很具體:分語言查、分語言記,把每個目標語言版本的網站內容做好,品牌資訊各語言一致
用中文查得到你是好事,但那只是一個市場。下一步,是用買家的語言去問一次。
🎯 讓每個目標語言的 AI 都找得到你
多語系 SEO 的下一步,是讓買家用他的語言問 AI 時,也找得到你。AI SEO Hacker 提供 AI 驅動的 SEO/GEO 文章服務,從目標市場的關鍵字規劃,到寫成 AI 讀得懂的內容,LINE 聊聊你的外銷市場。